Pi05
流程概览
训练
   pi05_base  (HF 预训练)
        │  finetune  (v3.0 数据集, 30 fps)
        ▼
   checkpoints/030000/pretrained_model  (bf16, chunk=50, 绝对动作)

        │
        ▼
量化 + 编译(oe_llm_s600/pi05_conver/)
   浮点参考   → 浮点基线 / 参考 dump
   校准       → fake-quant 权重 + time-mod LUT
   伪量化评估 → 伪量化精度 (校准集)
   编译       → 3× HBM (w8 nash-p)

        │
        ▼
板端部署与运行
   3× HBM + norm_stats_runtime.json + tokenizer/
   服务端 (vla_sdk_demo) + 客户端 (case_client)
- 模型:PaliGemma(gemma_2b) + Gemma 动作专家(gemma_300m),3 路相机 + 14 维 state/action,chunk=50,10 步去噪。
- 量化:int8 权重(w8)+ fake-quant 校准,编译为 nash-p HBM。
运行效果
硬件清单
Pi0 & Pi05 不要求使用指定的机械臂或结构,下表仅为参考硬件清单。更换其他机械臂、其他结构同样可以,但需要重新采集数据、重新训练并重新量化编译。
| 设备名称 | 数量 | 图片 |
|---|---|---|
| RDK S600 开发套件 | 1 | 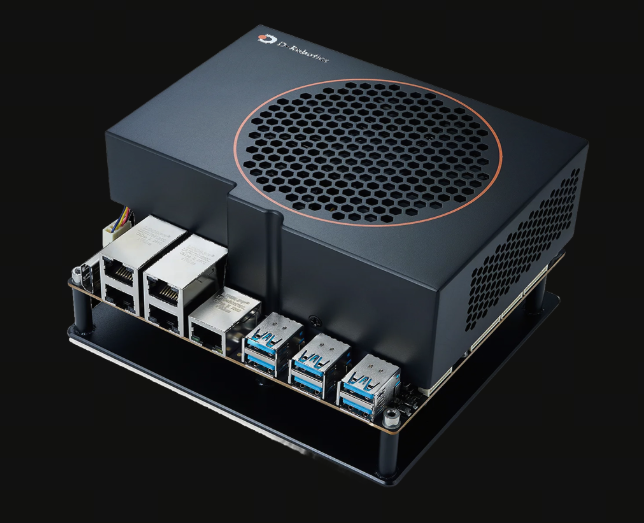 |
| 松灵 Piper 机械臂 | 2 | 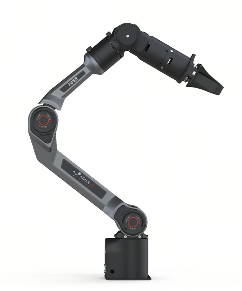 |
| RealSense D435i | 3 | 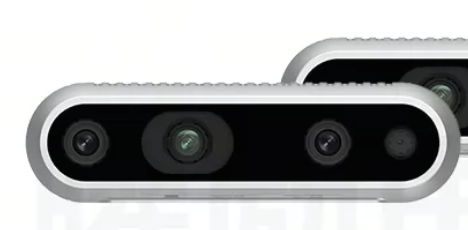 |
| 机械臂支架 | 1 | 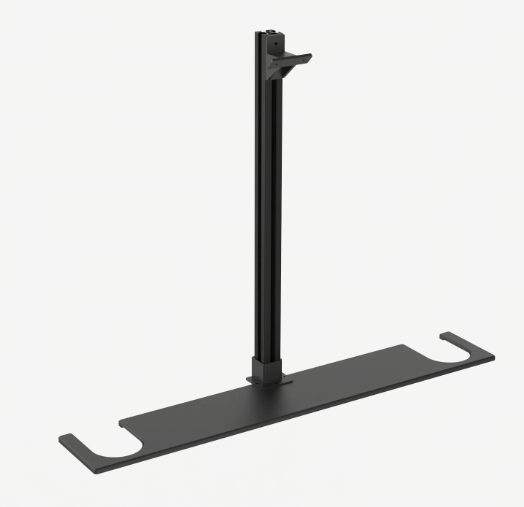 |
| 手部相机 3D 打印件 | 2 | 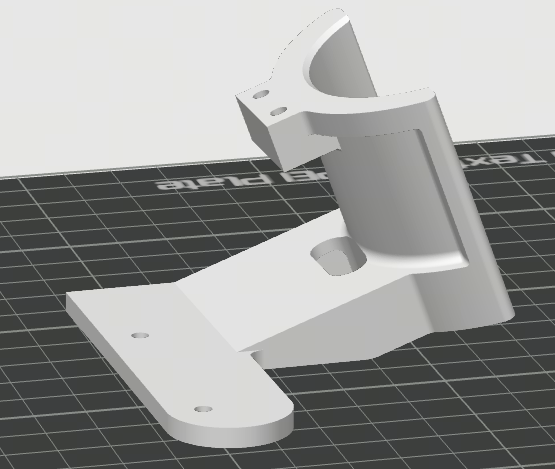 |
| 头部相机 3D 打印件 | 1 | 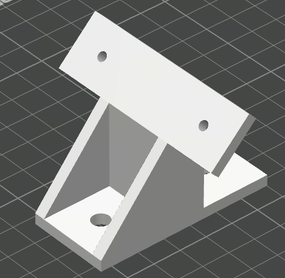 |
获取工具包
wget https://archive.d-robotics.cc/downloads/rdk_demo/rdk_s600_demo/pi05_s600.tar.gz
训练
环境准备
| 用途 | conda 环境 | 说明 |
|---|---|---|
| 训练 | lerobot |
|
-
基础环境搭建完成之后,先激活训练环境
lerobot,再进入仓库安装依赖:conda activate lerobot
git clone https://github.com/huggingface/lerobot.git
cd lerobot
pip install -e ".[core_scripts]" # For robot workflows (recording, replaying, calibrate)
pip install -e ".[training]" # For training policies
pip install -e ".[all]" # Everything (all policies, envs, hardware, dev tools) -
数据集格式:训练用 v3.0(
CODEBASE_VERSION=v3.0),v2.1 需先转 v3.0(convert_dataset_v21_to_v30.py)。v2.1/v3.0 的目录结构对照见 数据集格式说明。本地数据转换在 clone 所在目录(lerobot的上一级)执行,--root换成自己的数据路径:python lerobot/src/lerobot/scripts/convert_dataset_v21_to_v30.py \
--repo-id=xxx \
--root=xxx \
--push-to-hub=false注意-
训练依赖两份 Hugging Face 资源:
-
预训练权重
lerobot/pi05_base,若可以正常访问 Hugging Face,则不必提前下载,训练时lerobot-train会按仓库名自动拉取。若网络较差,可参考下方命令,先下载权重到本地,训练时设置HF_HUB_OFFLINE=1,并更换路径即可。 -
google/paligemma-3b-pt-224是 gated 模型,下载前需要先授权:登录 Hugging Face,打开 google/paligemma-3b-pt-224,点击 Acknowledge license 同意 Gemma 使用许可,填写信息获取授权后,即可下载模型。
-
-
网络较差,或训练命令带有
HF_HUB_OFFLINE=1(只读本地文件,不再访问 Hugging Face)时,在lerobot目录下提前下载。./pi05_base作为--policy.pretrained_path。下载完成后,把pi05_base/policy_preprocessor.json里的tokenizer_name改为./paligemma-3b-pt-224。cd lerobot
hf download lerobot/pi05_base --local-dir ./pi05_base
hf download google/paligemma-3b-pt-224 --local-dir ./paligemma-3b-pt-224
-
-
若训练时欲通过 wandb 查看模型训练情况,可先登录:
wandb login YOUR_API_KEY
训练命令
示例数据不对外开放,开发者根据实机环境和应用场景自行采集。--dataset.repo_id 与 --dataset.root 中的 xxx 换成自己的数据集标识和路径。
#启动lerobot环境
cd lerobot
conda activate lerobot

#从 pi05_base 微调(数据集若需要重映射则使用rename_map)
HF_HUB_OFFLINE=1 lerobot-train \
  --dataset.repo_id=xxx \
  --dataset.root=xxx \
  --policy.type=pi05 \
  --output_dir=./outputs/pi05_training \
  --job_name=pi05_training \
  --policy.pretrained_path=./pi05_base \
  --policy.gradient_checkpointing=true \
  --policy.dtype=bfloat16 \
  --policy.compile_model=true \
  --policy.freeze_vision_encoder=true \
  --policy.train_expert_only=true \
  --policy.push_to_hub=false \
  --policy.normalization_mapping='{"ACTION":"MEAN_STD","STATE":"MEAN_STD","VISUAL":"IDENTITY"}' \
  --policy.device=cuda \
  --batch_size=32 --num_workers=1 --steps=30000 --save_freq=5000 --seed=1000 \
  --wandb.enable=true \
  --wandb.project=pi05_training \
  --rename_map '{"state":"observation.state","head_cam":"observation.images.head_cam",
"left_cam":"observation.images.left_cam","right_cam":"observation.images.right_cam"}'

# 若需断点重训,可参考一下指令:
HF_HUB_OFFLINE=1 lerobot-train \
  --config_path=outputs/pi05_training/checkpoints/030000/pretrained_model \
  --resume=true --steps=60000 --dataset.eval_split=0.05 --eval_steps=1000
关键配置
train_config.json / config.json
| 项 | 值 |
|---|---|
| policy | pi05(gemma_2b + gemma_300m) |
| batch | 32 |
| steps | 30000 |
| dtype | bfloat16 compile_model=true compile_mode=max-autotune |
| freeze | true |
| train_expert_only | true |
| chunk | 50 |
| action / state | 输出 14 维(pad 32);state 14 维(pad 32) |
| 归一化 | ACTION/STATE=MEAN_STD VISUAL=IDENTITY |
| tokenizer | tokenizer_max_length=200 |
训练资源与耗时
| 项 | 值 |
|---|---|
| 机器 | 1× NVIDIA RTX 5090 32GB(32607 MiB,驱动 610.57.04)+ Intel i9-14900KF(32 线程) |
| GPU 显存占用 | ~21.9 GB |
| batch | 32 |
| 精度 | bfloat16 |
| 显存优化 | gradient_checkpointing=true freeze_vision_encoder=true train_expert_only=true compile_model=true |
| 训练步数 | 30000 |
| 数据时长 | 35s |
| 数据数量 | 300 条 |
| 该段耗时 | ~17.5 h |
数据集格式说明
lerobot 存在 v2.1 与 v3.0 两种数据集格式。本次使用的训练环境 lerobot(0.6.2,CODEBASE_VERSION=v3.0)只能读 v3.0。示例数据不对外开放,开发者根据实机环境和应用场景自行采集。
v2.1
.
├── meta/
│   ├── info.json              codebase_version = "v2.1"
│   ├── tasks.jsonl            {"task_index":0,"task":"Fold the towel from bottom to top twice, then from right to left."}
│   ├── episodes.jsonl         {"episode_index","tasks","length"}
│   ├── episodes_stats.jsonl   {"episode_index","stats":{feature:{min,max,mean,std,count}}}
│   └── modality.json          state/action/endpose/... 的分段索引
├── data/
│   └── chunk-000/
│       ├── episode_000000.parquet     ← 一 episode 一文件(共 320 个)
│       └── ...
└── videos/
    └── chunk-000/
        ├── head_cam/episode_000000.mp4
        ├── left_cam/episode_000000.mp4
        └── right_cam/episode_000000.mp4
v3.0
.
├── meta/
│   ├── info.json              codebase_version = "v3.0"
│   ├── tasks.parquet          task_index | task
│   ├── stats.json             聚合 stats
│   └── episodes/
│       └── chunk-000/
│           └── file-000.parquet      ← 一行一 episode(data/video 索引 + from/to_ts + length + 各 feature 的 stats 列)
├── data/
│   └── chunk-000/
│       ├── file-000.parquet          ← 按 data_files_size_in_mb 聚合
│       └── ...
└── videos/
    ├── head_cam/chunk-000/file-000.mp4     ← video_key 提到 chunk 之前,按 video_files_size_in_mb 聚合
    ├── left_cam/chunk-000/file-000.mp4
    └── right_cam/chunk-000/file-000.mp4
关键差异
| 项 | v2.1 | v3.0 |
|---|---|---|
| data | 一个 episode 对应一个文件 | 多个 episode 聚合成一个文件 |
| video | 一个 episode 对应一个 video 文件 | 多个 episode 聚合成一个 video 文件 |
| 逐 episode 元数据 | episodes.jsonl + episodes_stats.jsonl | meta/episodes/chunk-XXX/file-XXX.parquet |
| task | tasks.jsonl | tasks.parquet |
| info.json | 无 per-feature fps、有 total_videos/total_chunks | 每个 feature 带 fps、有 data_files_size_in_mb |
| modality.json | 有 | 无 |
量化编译
获取 SDK
量化编译需要先下载并解压官网 LLM SDK。~/VLA 是示例工作目录,新开终端需要重新设置 SDK。
mkdir -p ~/VLA/oe_llm_s600/pi05_sdk
cd ~/VLA/oe_llm_s600/pi05_sdk
wget https://archive.d-robotics.cc/toolchain/llm/s100_s600_llm/llm_2.0.0/D-Robotics_LLM_2.0.0_S600_S100_SDK.tar.gz
tar -xzf D-Robotics_LLM_2.0.0_S600_S100_SDK.tar.gz
export SDK=$HOME/VLA/oe_llm_s600/pi05_sdk/D-Robotics_LLM_2.0.0_S600_S100_SDK
cd ~/VLA
环境准备
已有 Pi0 量化环境时直接复用,不必再建。
conda create -n oellm python=3.10 -y
conda activate oellm
pip install torch==2.8.0+cu128 torchvision==0.23.0+cu128 torchaudio==2.8.0+cu128 --index-url https://download.pytorch.org/whl/cu128
pip install $SDK/package/host/*.whl          # horizon / hbdk / hbm
pip install -r $SDK/llm_compression/requirements.txt
pip install numpy==1.26.4
pip install --force-reinstall setuptools==80.10.2

# 创建 pi05_conver 文件夹,量化所需文件以及生成产物都放在 pi05_conver
mkdir oe_llm_s600/pi05_conver
数据与模型准备
用 pi05_s600/host/prep_pi05.py 生成模型目录、校准数据和 norm_stats_runtime.json,再用 prepare_sdk20.py 生成官网 SDK 的 samples.json 与 sdk20/ 配置。
cd ~/VLA
conda activate lerobot
python3 pi05_s600/host/prep_pi05.py \
  --ckpt-dir lerobot/outputs/pi05_training/checkpoints/030000 \
  --dataset-root xxx \
  --output-dir oe_llm_s600/pi05_conver --num-samples 30 \
  --tokenizer lerobot/paligemma-3b-pt-224/tokenizer.model --copy-tokenizer

conda activate oellm
python3 pi05_s600/tools/apply_sdk_patches.py --sdk "$SDK" --scope host
python3 pi05_s600/host/prepare_sdk20.py \
  --assets oe_llm_s600/pi05_conver \
  --checkpoint lerobot/outputs/pi05_training/checkpoints/030000
~/VLA只是示例工作目录,可换为现有目录;数据路径按实际修改。
| 产物 | 说明 | |
|---|---|---|
| 模型目录 | <output-dir>/model_<step>/config.json | Pi05Config 架构常量:max_token_len=200、无 uses_state |
<output-dir>/model_<step>/model.safetensors | 由原生 ckpt 自动去 model. 前缀生成 | |
<output-dir>/model_<step>/paligemma_tokenizer.model | tokenizer 软链(默认从 --ckpt-dir 自动定位) | |
| 校准数据 | <output-dir>/pi05_calib_image/{sid}/image_{0,1,2}.jpg | head / left / right(640×480,quality 95) |
<output-dir>/pi05_action_calib_data/{sid}/state.npyaction.npyx_t.npy | [14] raw + [50,32] flow 噪声 | |
<output-dir>/pi05_prompt.json | [{"text": ...} x N](默认读数据集 tasks) | |
<output-dir>/norm_stats.json | actions 的 mean/std/q01/q99(全量统计) | |
| 板端 norm | <output-dir>/norm_stats_runtime.json | state + actions 的 mean/std/q01/q99(板端运行时用) |
| 官网 SDK 输入 | <output-dir>/sdk20/samples.json | calibration 与 evaluation 的 data_path |
<output-dir>/sdk20/float.yml | 浮点参考。已去掉 evaluation.calib_ckpt_load_path | |
<output-dir>/sdk20/case.yml | 校准、伪量化评估和编译。后续命令使用这些生成文件 | |
- 采样约定:对数据集全局帧等距采集,相机序固定 head→left→right。action/state 存 raw 物理量。
- --ckpt-dir 是输入(原生 lerobot 模型目录)。
- --model-dir 是输出(转换后的 llm_compression 目录,默认 <output-dir>/model_<step>)。
- model. 前缀去除在脚本内完成。
量化编译
在 pi05_conver/ 下依次做浮点参考、校准、伪量化评估和编译:
conda activate oellm
cd ~/VLA/oe_llm_s600/pi05_conver
export PYTHONPATH="$SDK:$SDK/llm_compression/lightcompress:${PYTHONPATH:-}"

# 1. 浮点参考
python3 ~/VLA/pi05_s600/host/native_float_reference.py --config_path "$PWD/sdk20/float.yml"
# 2. 校准,调用官网 calib.py,关闭梯度记录
python3 ~/VLA/pi05_s600/host/calib_no_grad.py --config_path "$PWD/sdk20/case.yml"
# 3. 伪量化评估
TORCH_FORCE_NO_WEIGHTS_ONLY_LOAD=1 bash "$SDK/llm_compression/scripts/torch_eval.sh" --config_path "$PWD/sdk20/case.yml"
# 4. 编译 HBM
TORCH_FORCE_NO_WEIGHTS_ONLY_LOAD=1 bash "$SDK/llm_compression/scripts/compile.sh" --config_path "$PWD/sdk20/case.yml"
sdk20/case.yml 关键项:
model:
  type: Pi05
  path: .../model_030000
  # norm_stats_path 使用含 state + actions 的 runtime 统计量
  norm_stats_path: .../norm_stats_runtime.json
  model_list: [visual, lm, action]
  model_dtype: bfloat16
  q_config: accuracy
  vision_token_num: 256
  num_views: 3
  action_horizon: 50
  max_token_len: 200
  discrete_state_input: true
  valid_state_dim: 14
  enable_time_mod_lut: true
calibration:
  dataset_type: vla_dataset
  calibration_step: 30
  # data_path 指向 sdk20/samples.json
evaluation:
  dataset_type: vla_dataset
  eval_step: 30
  use_delta_joint_actions: false
  use_quantiles_norm: false
  vla_eval:
    eval_stages: [calib]
    valid_action_dim: 14
    skip_dump_if_exists: false
compile:
  opt_level: 2
  jobs: 32
  lm: {enable_hpc: true, core_num: 4, max_l2m_size: 25165824}
  action: {enable_hpc: false, core_num: 4, max_l2m_size: 25165824}
产物
| 文件 | 部件 | 大小 |
|---|---|---|
| xxxx_vision_224x224_w8_nash-p_corenum_1.hbm | SigLIP | ~487 MB |
| xxxx_llm_action_horizon_50_w8_nash-p_corenum_4.hbm | Gemma-2B LM | ~3.56 GB |
| xxxx_action_horizon_50_w8_nash-p_corenum_4.hbm | Gemma-300M 动作专家 | ~492 MB |
- 量化精度:模型精度指标参见 量化精度,量化模型精度查验与调优见 OELLM 2.0 手册「精度评测」章节,此处不展开。
- 编译耗时(Intel Core i9-14900KF):visual ~26min + lm ~2h15min + action ~54min ≈ 3.5h。
板端部署与运行
将三个 HBM、SDK 和新源码包导入板端。
- 源码包解压到
/root/VLA/pi05_s600,SDK 解压到/root/VLA/oe_llm_s600/pi05_sdk。 - 三个 HBM 放到
/root/VLA/pi05_models,同时放入含 state 和 actions 的norm_stats_runtime.json(改名为norm_stats.json)、tokenizer.json、tokenizer_config.json,以及tokenizer.model(改名为paligemma_tokenizer.model)。 - 如果编译另有 time-mod LUT 导出文件,一并导入。
运行所需文件
模型资源(/root/VLA/pi05_models):
/root/VLA/pi05_models/
├── model_030000_vision_224x224_w8_nash-p_corenum_1.hbm
├── model_030000_language_w8_nash-p_corenum_4.hbm
├── model_030000_action_ah_50_w8_nash-p_corenum_4.hbm
├── norm_stats.json                            # norm_stats_runtime.json 改名,必须含 state + actions
├── paligemma_tokenizer.model                  # tokenizer.model 改名
└── tokenizer.json / tokenizer_config.json
案例配置(/root/VLA/pi05_s600):
/root/VLA/pi05_s600/
├── configs/runtime.json                       # configure.py 生成的模型配置
├── configs/network.json                       # 网络配置(127.0.0.1:30005)
└── configs/client.yaml                        # 客户端与机械臂配置
构建运行时
安装板端构建依赖,然后应用补丁、构建 full runtime 并生成案例配置:
apt-get update
apt-get install -y build-essential cmake pkg-config libopencv-dev libprotobuf-dev \
  protobuf-compiler python3-venv ffmpeg patch

export SDK=/root/VLA/oe_llm_s600/pi05_sdk/D-Robotics_LLM_2.0.0_S600_S100_SDK
python3 /root/VLA/pi05_s600/tools/apply_sdk_patches.py --sdk "$SDK" --scope board
source "$SDK/oellm_runtime_s600/env.sh" 4
cd "$SDK/oellm_runtime_s600/examples/vla_demo/pi0"
BUILD_TARGET=full MODE=full bash build_demo.sh
cd /root/VLA/pi05_s600
bash case_client/setup.sh
./case_client/.venv/bin/python -m pip install pillow pyarrow
./case_client/.venv/bin/python board/configure.py --model-dir /root/VLA/pi05_models
运行时配置参考
配置示例使用包内 configs/runtime.template.json。运行时加载 board/configure.py 生成的 configs/runtime.json。模板已填写三个 HBM 文件名,生成脚本把模型目录绑定到 /root/VLA/pi05_models。
configs/runtime.template.json
{
  "runtime_type": "Pi0Sdk",
  "model": {
    "version": "0.5",
    "denoise_num": 10,
    "work_path": ".",
    "model_runner": {
      "visual": "model_030000_vision_224x224_w8_nash-p_corenum_1.hbm",
      "lm": "model_030000_language_w8_nash-p_corenum_4.hbm",
      "action": "model_030000_action_ah_50_w8_nash-p_corenum_4.hbm"
    },
    "backends": {
      "visual": [1, 2, 3],
      "lm": [1, 2, 3, 4],
      "action": [1, 2, 3, 4]
    },
    "state_size": 14,
    "num_flow_steps": 10,
    "use_rtc": true
  },
  "interface": {
    "action_horizon": 50,
    "raw_state_size": 14,
    "raw_action_size": 14,
    "image_mask": [true, true, true]
  },
  "processing": {
    "preproc": true,
    "postproc": true,
    "filter": {"type": "none", "fs": 0},
    "use_absolute_action": true,
    "use_quantiles_norm": false,
    "delta_action_mask": [1, 1, 1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1, 0],
    "inject_state": true
  },
  "dfx": {
    "dump": false,
    "dump_per_chunk": false,
    "dump_dir": "./output/",
    "stub_dir": "./stub/"
  },
  "warm_start": {"enabled": false},
  "rtc": {
    "execution_horizon": 15,
    "leftover_count": 10,
    "inference_delay": 9,
    "max_guidance_weight": 5.0,
    "prefix_attention_schedule": "linear",
    "control_frequency": 30.0,
    "use_model_prev": true
  }
}
configs/network.json
{
  "default_mode": "network",
  "modes": ["local", "network"],
  "io": {
    "input_dir": "./inputs",
    "output_dir": "./outputs/openloop",
    "multi_chunk": true,
    "reset_filter_first": true
  },
  "demo": {"infer_nums": 1, "image_count": 3, "language_count": 1, "state_count": 1},
  "network": {"server_ip": "127.0.0.1", "server_port": 30005, "timeout": 120}
}
- 保留
runtime_type=Pi0Sdk、model.version为"0.5"、state_size=14、processing.inject_state=true。 model.num_flow_steps=10,同时保留denoise_num=10。滤波为processing.filter.type=none、fs=0,warm_start.enabled=false。RTC 原参数保留,并设置rtc.use_model_prev=true。- 客户端发送原始 state,runtime 按 checkpoint 的 MEAN_STD(float32、epsilon=1e-8)归一化后,以有效 14 维离散化注入文本,与本包 Pi05 板端补丁配套,不套用 Pi0 的 32 维连续 state 补零规则。
- 相机序列号和左右臂 CAN 映射填入
configs/client.yaml,两路 CAN 为 1 Mbps。其他参数使用配套配置。 - 输入图:可发 640×480 交给板端 resize(板端 ResizeWithPadToBuffer 非抗锯齿,与训练 torch 一致)。
- 运行时端口:
configs/network.json(server_port=30005)。
开环测试
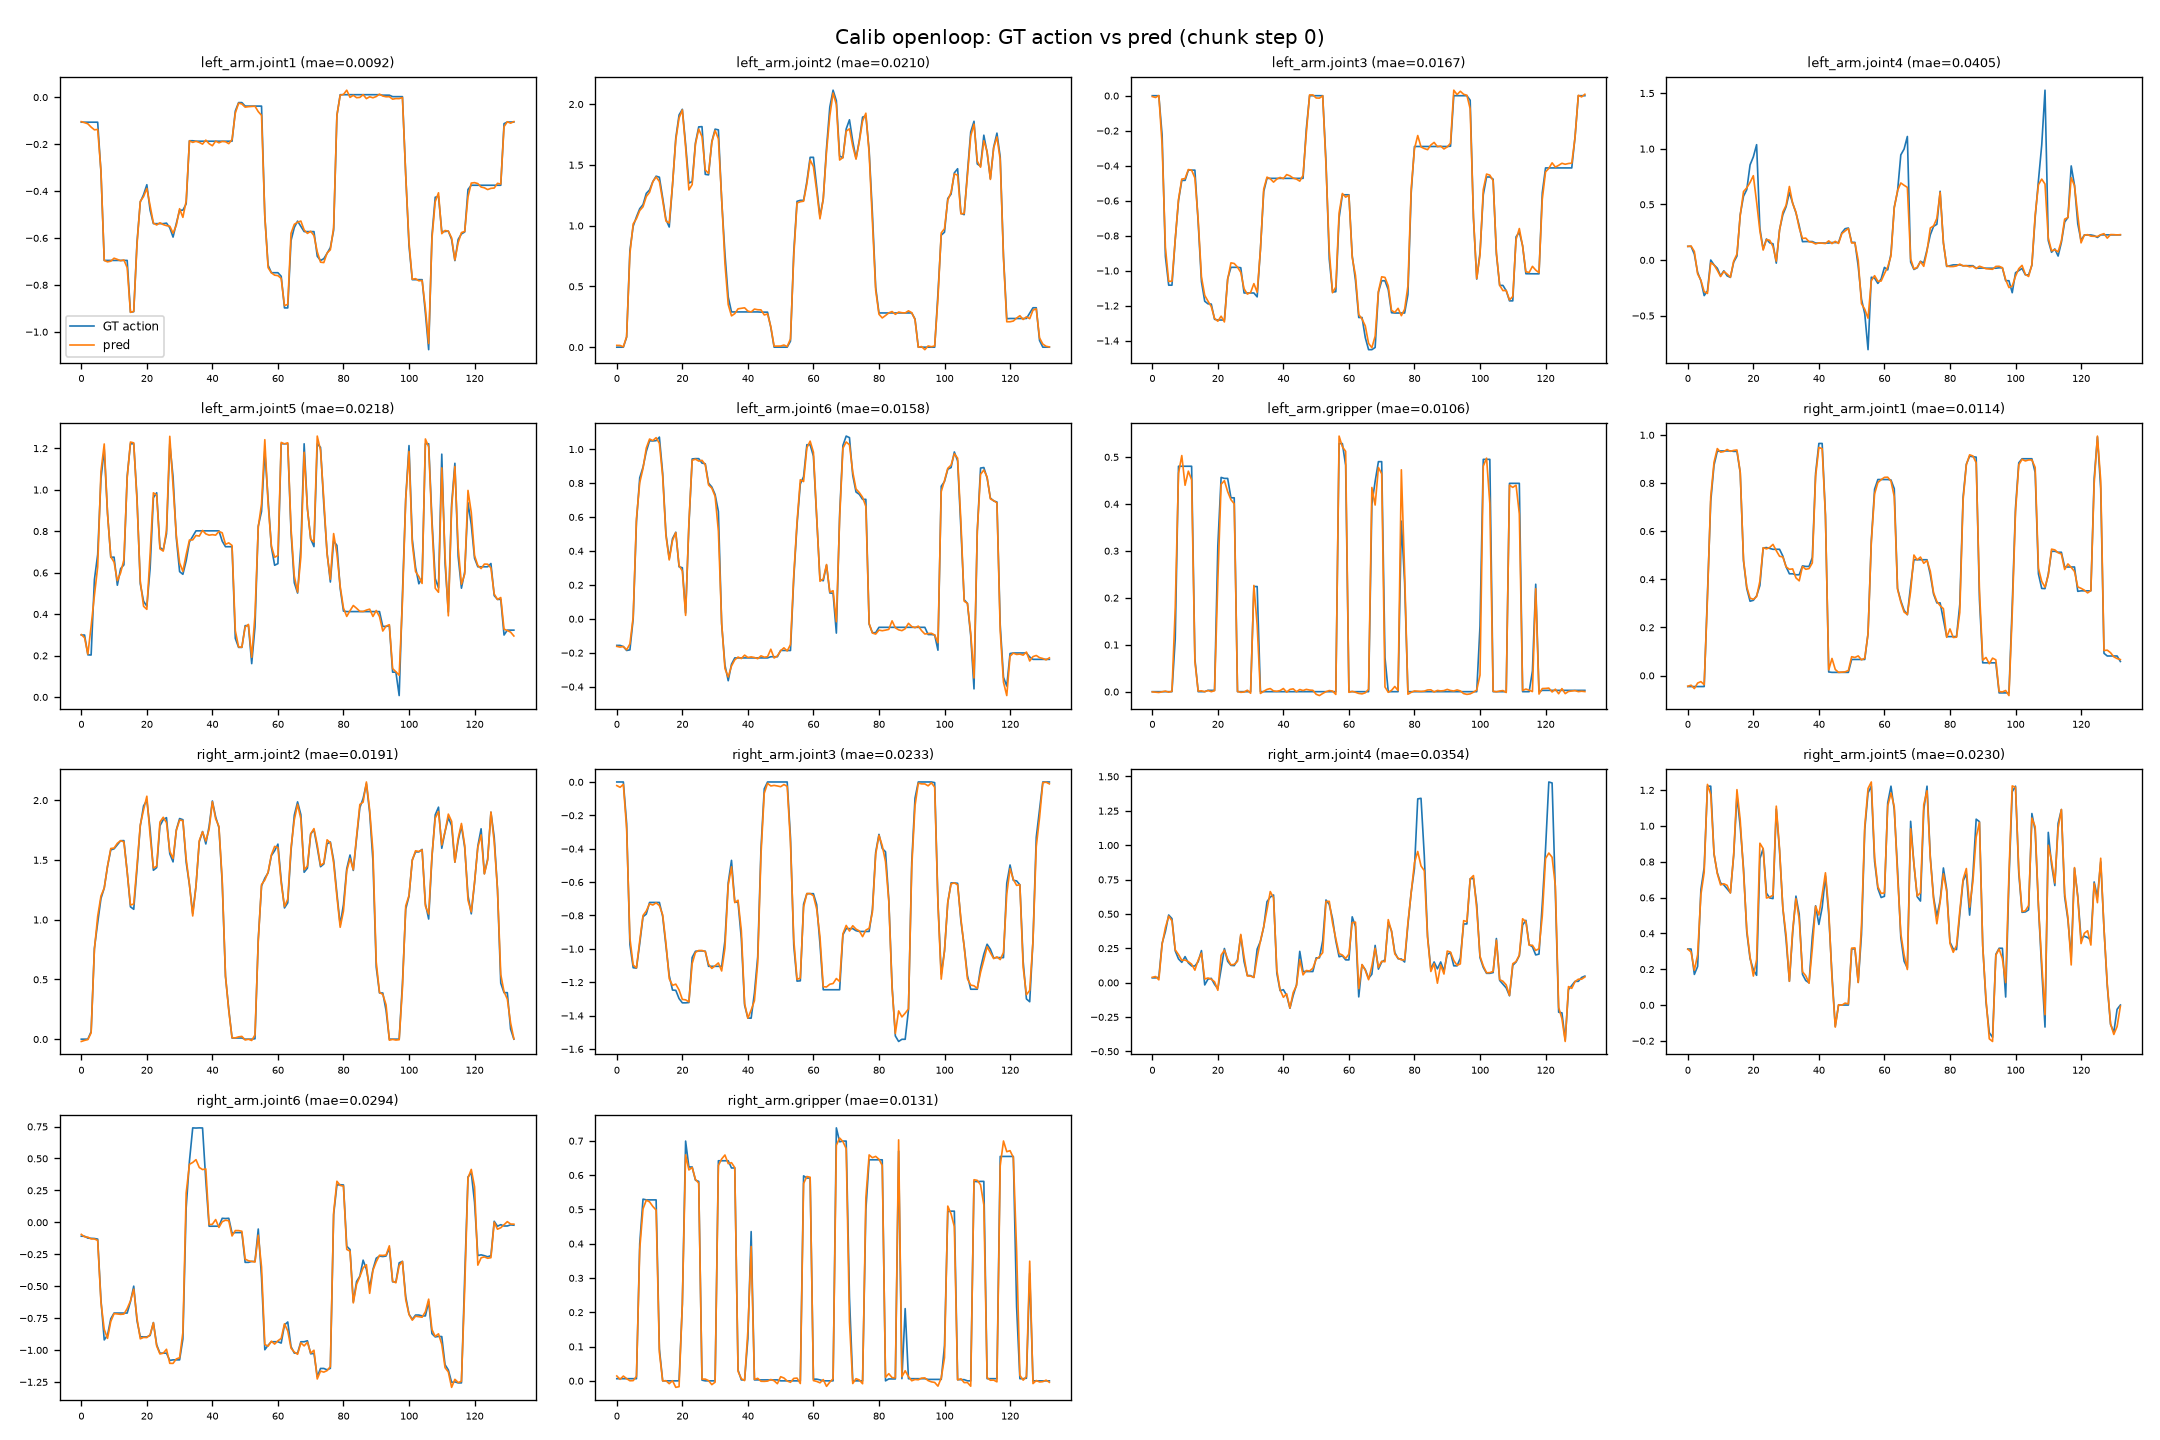
不开硬件或遥控,也不启动机械臂客户端。用 GT 观测(图像 + state)逐步喂板端 HBM,把预测动作与 GT 对比。板端脚本为 pi05_s600/board/openloop_infer_piper.py。结果是预测记录和误差统计,不依赖旧绘图脚本。
数据获取(训练机侧)
用 pi05_s600/host/extract_episodes_v3.py 从 v3.0 数据集抽取指定 episode。--dataset-root 的 xxx 换成实际 v3.0 数据目录,保留 episode 0、3、5 和 stride=30:
conda activate lerobot
# 抽 episode 0/3/5,每个 episode 每 30 帧一条(≈ 每个 chunk 起点)
python3 pi05_s600/host/extract_episodes_v3.py \
  --dataset-root xxx \
  --episodes 0 3 5 --stride 30 -o eval_data
# 每个 episode 均匀抽 20 条:加 --num-per-episode 20
将输出导入板端 /root/VLA/eval_data。输入布局保持不变:
eval_data/calib_image/<sid>/image_{0,1,2}.jpg        # head_cam, left_cam, right_cam
eval_data/action_calib_data/<sid>/state.npy          # [14] raw
eval_data/action_calib_data/<sid>/action.npy         # [14] GT (chunk step0, raw)
eval_data/action_calib_data/<sid>/x_t.npy            # [50,32](板端不用)
eval_data/prompt.json · norm_stats.json · manifest.json
板端开环
沿用前文客户端环境,加载同一 SDK 的 env.sh 4,并把 vla_demo/pi0/dist 加入 LD_LIBRARY_PATH:
cd /root/VLA
export SDK=/root/VLA/oe_llm_s600/pi05_sdk/D-Robotics_LLM_2.0.0_S600_S100_SDK
source "$SDK/oellm_runtime_s600/env.sh" 4
export LD_LIBRARY_PATH="$SDK/oellm_runtime_s600/examples/vla_demo/pi0/dist:${LD_LIBRARY_PATH:-}"
./pi05_s600/case_client/.venv/bin/python pi05_s600/board/openloop_infer_piper.py \
  --model pi05 --model-dir /root/VLA/pi05_models \
  --model-config /root/VLA/pi05_s600/configs/runtime.json \
  --sdk-root "$SDK/oellm_runtime_s600" \
  --demo-dir "$SDK/oellm_runtime_s600/examples/vla_demo/pi0" \
  --eval-data /root/VLA/eval_data --output-dir /root/VLA/pi05_s600/outputs/openloop --no-plots \
  --model-config-patch '{"model":{"use_rtc":false}}'
--model pi05。用 pi0 HBM 加 pi05 预设会报[layout] suffix_pad=1 invalid ... suffix layout mismatch with HBM(version/suffix 不匹配)。--model-dir决定读哪个目录的 3 个.hbm。norm_stats默认取--model-dir/norm_stats.json,必须含 state。- 按
stride=30抽取的 GT 观测彼此不连续。默认 RTC 会沿用上一段预测缓存,开环误差会被放大。上面的--model-config-patch只在这次独立样本开环里关闭 RTC,真机仍使用configs/runtime.json里的 RTC 配置。 - 开环耗时是 runtime 内部计时,脚本汇总全部样本的 profile,输出平均耗时与 P95。
- 命令带
--no-plots,输出预测记录和误差统计,不调用旧绘图脚本; 不带--no-plots才会出下图所示的预测曲线。开环不启动机械臂客户端。
真机运行
客户端改用 board/pi05_live_client.py。prompt 从 YAML 读取,runtime 连接后才开始任务计时,不要附加 --prompt。连接会自动使能双臂。现场确认急停和工作区后再执行。
在 /root/VLA/pi05_s600/case_client 核对设备并归位:
cd /root/VLA/pi05_s600/case_client
./run_arm.sh --list
# 按现场映射启用两路 1 Mbps CAN,例如:
# sudo ip link set can_left up type can bitrate 1000000
# sudo ip link set can_right up type can bitrate 1000000
./run_arm.sh --config ../configs/client.yaml
./run_arm.sh --config ../configs/client.yaml --home
归位并铺平毛巾后,先启动客户端,再启动 runtime。
# 板端终端 1
cd /root/VLA/pi05_s600
./case_client/.venv/bin/python board/pi05_live_client.py --config configs/client.yaml --duration 120
# 板端终端 2
export SDK=/root/VLA/oe_llm_s600/pi05_sdk/D-Robotics_LLM_2.0.0_S600_S100_SDK
cd "$SDK/oellm_runtime_s600/examples/vla_demo/pi0"
source "$SDK/oellm_runtime_s600/env.sh" 4
export LD_LIBRARY_PATH="$PWD/dist:${LD_LIBRARY_PATH:-}"
./dist/vla_sdk_demo --oellm_config /root/VLA/pi05_s600/configs/runtime.json \
  --demo_config /root/VLA/pi05_s600/configs/network.json --mode network
- 配置:
configs/client.yaml(prompt、服务端端口、相机序列号、14 维关节名,以及arms节中的 CAN 口、夹爪行程与力、sleep_position)。 - 重点核对相机序列号,以及机械臂 CAN 口名称与现场一致。两路 CAN 为 1 Mbps。
- 客户端进程监听
server.host:server.port(默认0.0.0.0:30005),板端 runtime 主动连入。
网络通信协议
-
角色方向:板端 runtime(dist/vla_sdk_demo --mode network)是 TCP client,主动 connect() 到客户端机器。客户端侧(arm_interface 部署链的相机/臂节点所在机器,参考实现 deploy/src/inference_runner/inference_runner/oellm_tcp.py::OellmTcpClient)是 TCP server。地址和端口在
configs/network.json的network.server_ip、network.server_port、network.timeout(默认127.0.0.1:30005)。 -
分帧:每帧 = [4 字节大端序长度][protobuf 字节流]。板端 vla_demo_network.h 用 htonl/ntohl 读写长度头、SerializeToString/ParseFromString 收发。客户端用 struct.pack(">I", len) 对齐。请求与响应同为一种消息(MultiModalInput)。
-
消息定义(oellm_runtime/examples/vla_demo/common/src/msg.proto):
message Time  { int64 sec = 1; int32 nsec = 2; }
message Header {
  uint32 seq = 1;      // 自增序列号
  Time   stamp = 2;    // 采集时刻
  string frame_id = 3;
  uint32 type = 4;     // 图像类型 (RGB/BGR)
  bool   reset = 5;    // 重置推演 (RTC: 任务开始清缓存)
  bool   view_only = 6;
}
message Tensor {
  enum DataType { FLOAT64=0; UINT8=1; STRING=2; FLOAT32=3; INT32=4; FP16=5; }
  DataType       dtype = 1;
  repeated int32 shape = 2;   // int32(跨架构)
  bytes          data  = 3;   // 原始字节
}
message MultiModalInput {
  Header         header    = 1;
  repeated Tensor images   = 2;  // num_views 张 (pi05=3),shape=[3,H,W] CHW,DT_UINT8
  repeated Tensor languages= 3;  // prompt 文本,DT_STRING(板端内部 tokenize)
  repeated Tensor states   = 4;  // state 向量,DT_FLOAT64(inject_state=true,注入 prompt)
} -
请求 → 响应:客户端发 images/languages/states(+可选 field 5/6 RTC 约束),板端回同型 MultiModalInput,动作放 languages[0](dtype 为 FLOAT64 或 FP16,shape = [action_horizon, action_dim] 的原始维度)。客户端 decode_response 即按 languages[0] 解。
-
pi05 的 state 注入 prompt(inject_state=true):客户端发原始值,由 runtime host 侧归一化(见下)。
请求格式与归一化
| 字段 | dtype | shape | 内容 | 是否归一化 |
|---|---|---|---|---|
| images[i] | DT_UINT8(也接受 FLOAT32/FP16) | [3, H, W](CHW,RGB) | 相机原图像素 0–255 | 未归一化;UINT8 时 runtime 内部统一做 ResizeWithPad(→224×224) + 归一化 |
| languages[0] | DT_STRING(或 DT_INT32) | [](或 [token_len]) | prompt 原文(UTF-8);或已分词 token ids | 不涉及(文本);runtime 内部 tokenize(pi05 inject_state=true,state 注入 prompt) |
| states[0] | DT_FLOAT64 | [14] | 原始关节值(双臂 6 关节+夹爪,raw 物理量) | 未归一化;runtime host 侧按 norm_stats_runtime.json 的 state.mean/std 归一化后再喂 HBM(preproc=true) |
| prev_actions(field 5) | DT_FLOAT64 | [n*14] 展平 | 上一 chunk 未执行的尾巴(raw) | 未归一化;engine 侧按 action 统计处理 |
- preproc=true(默认):states 必须发 raw(DT_FLOAT64)——网络层据 dtype 置 state_raw=true,runtime 才做归一化。发 DT_FLOAT32 会被当作“已归一化”(state_raw=false),不要在客户端预归一化。
- preproc=false:输入须已预处理——states 必须是已归一化值且长度 == state_size(=14),languages 必须发 DT_INT32 token ids(prompt 文本无法离线转 tokens),否则报错。
- 图像若设 obs.image_size=[0,0](不缩放),客户端把相机原图(如 1280×720)交给 runtime,由 runtime 统一 ResizeWithPad 到 224×224 再归一化。
- 响应侧 languages[0] 的动作是模型输出空间的绝对关节动作(配合 use_absolute_action/filter 等 processing),与上述请求张量的原始量纲不同。
问题与解决方法
训练 / 数据
| 现象 | 根因 | 解决 |
|---|---|---|
| 加载卡死 / 访问 huggingface 超时 | 离线环境仍尝试联网 | HF_HUB_OFFLINE=1;base 权重走 hf-mirror 镜像本地化 |
| tokenizer 加载失败(gated) | google/paligemma-3b-pt-224 需授权 | 本地下载并改 pi05_base/policy_preprocessor.json 路径;训练后 ckpt 自带 tokenizer/ |
| v2.1 数据集读不了 | lerobot ≥0.4 抛 BackwardCompatibilityError | 训练/校准用 v3.0;v2.1 用 drrm(0.3.3) 或先转 v3.0(格式差异见 数据集格式说明) |
| 数据集 key 是扁平名 | 训练特征名与策略不符 | --rename_map 映射 head_cam→observation.images.head_cam 等 |
板端运行时
| 现象 | 根因 | 解决 | 效果 |
|---|---|---|---|
| 动作完全不对 | num_flow_steps 未设为 10(velocity 当 x_t 回灌) | model.num_flow_steps=10 | 0.4955 → 0.4172 |
| 动作完全不对 | use_absolute_action 缺省 false(又叠一次 state) | use_absolute_action=true | 量级 1.99 → 1.00 |
| norm_stats 初始化失败 | norm_stats.json 只有 actions 缺 state | 用 norm_stats_runtime.json(含 state) | — |
数据 / 配置
| 项 | 训练侧 | 板端 |
|---|---|---|
| 归一化 | MEAN_STD;state/action 14 维 | norm_stats_runtime.json(state+actions) |
| 动作空间 | 绝对动作 | use_absolute_action=true |
| state | 注入 prompt(inject_state) | inject_state=true + state_size=14 |
| 图像 | 480×640 存储,模型内 resize 224 | 先 openpi resize_with_pad 到 224 |
验收指标参考
量化精度
仅作为本任务的参考,校准集 30 样本,伪量化 vs float。
| 阶段 | 指标 | 值 |
|---|---|---|
| calib_eval | action MAE | 0.009048 |
| calib_eval | action RMSE | 0.016222 |
| calib_eval | action cosine | 0.999232 |
| calib_eval | tensor MAE | 0.015608 |
| calib_eval | tensor cosine | 0.999274 |
以上为 runtime 内计时:preproc 0.1ms + visual 20ms + lm 108ms + action 125ms + postproc 0.1ms ≈ 255-270ms。此处为高精度版本,若欲提升推理性能,可参考 OELLM 工具链中的均衡版本以及高性能版本
实机资源占用
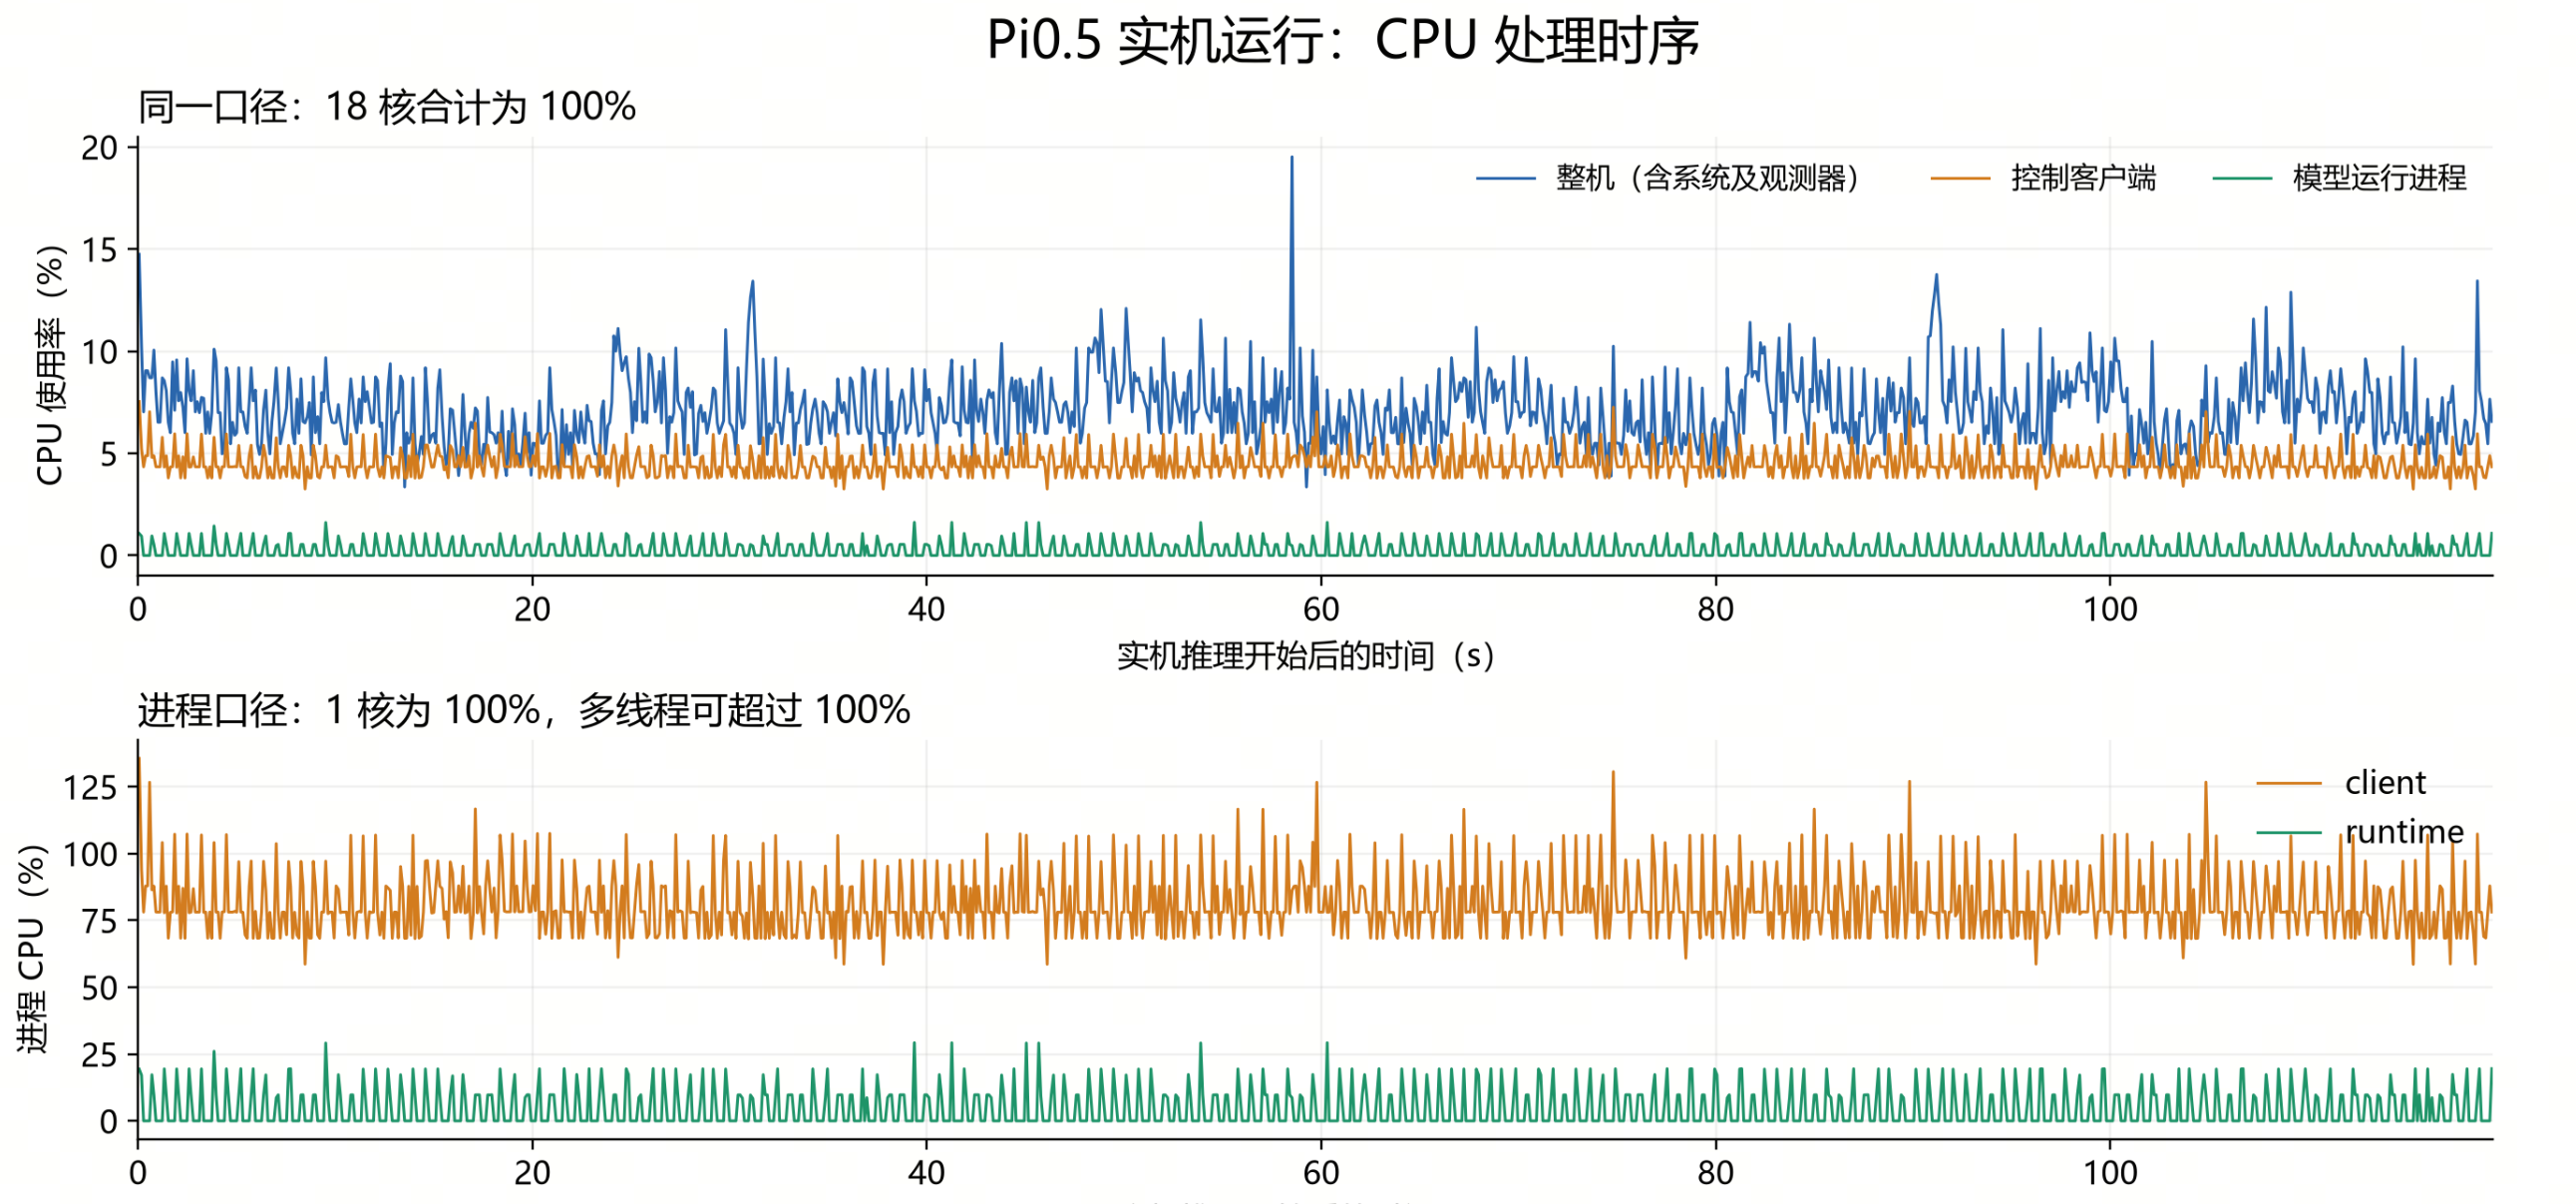
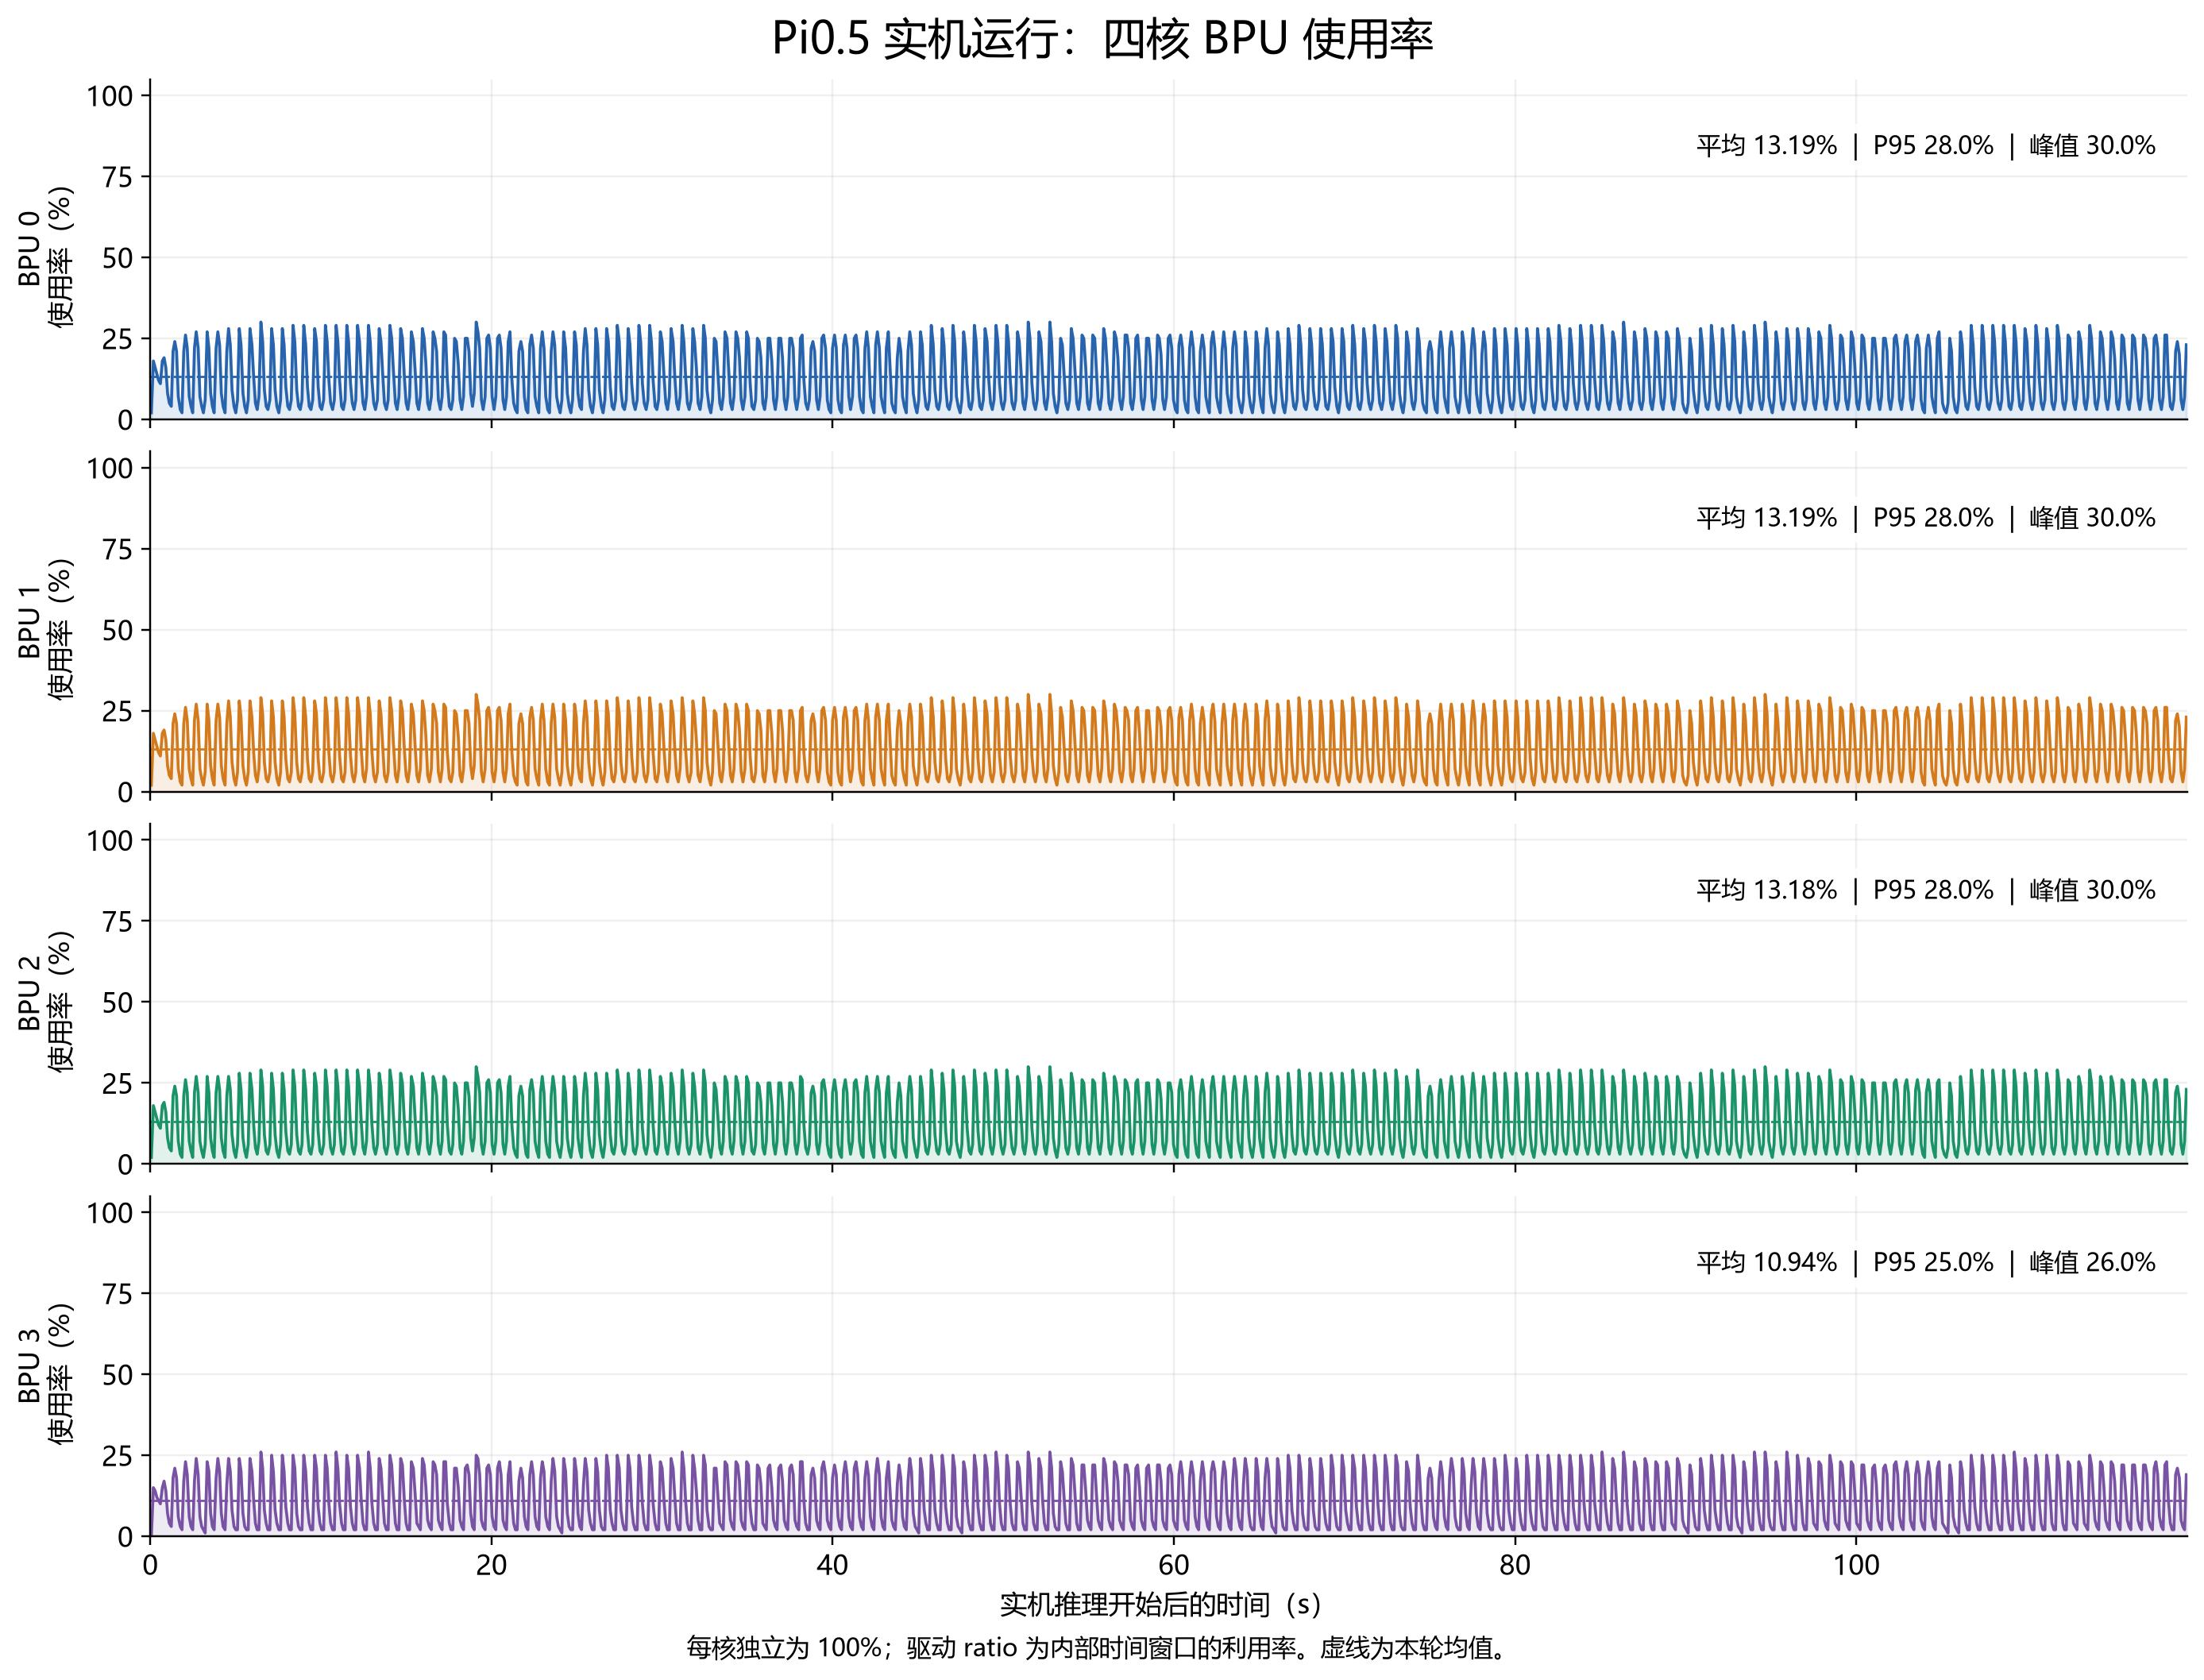
折毛巾实机运行时,RDK S600 的 CPU 与四核 BPU 占用如下。
CPU 占用
四核 BPU 使用率
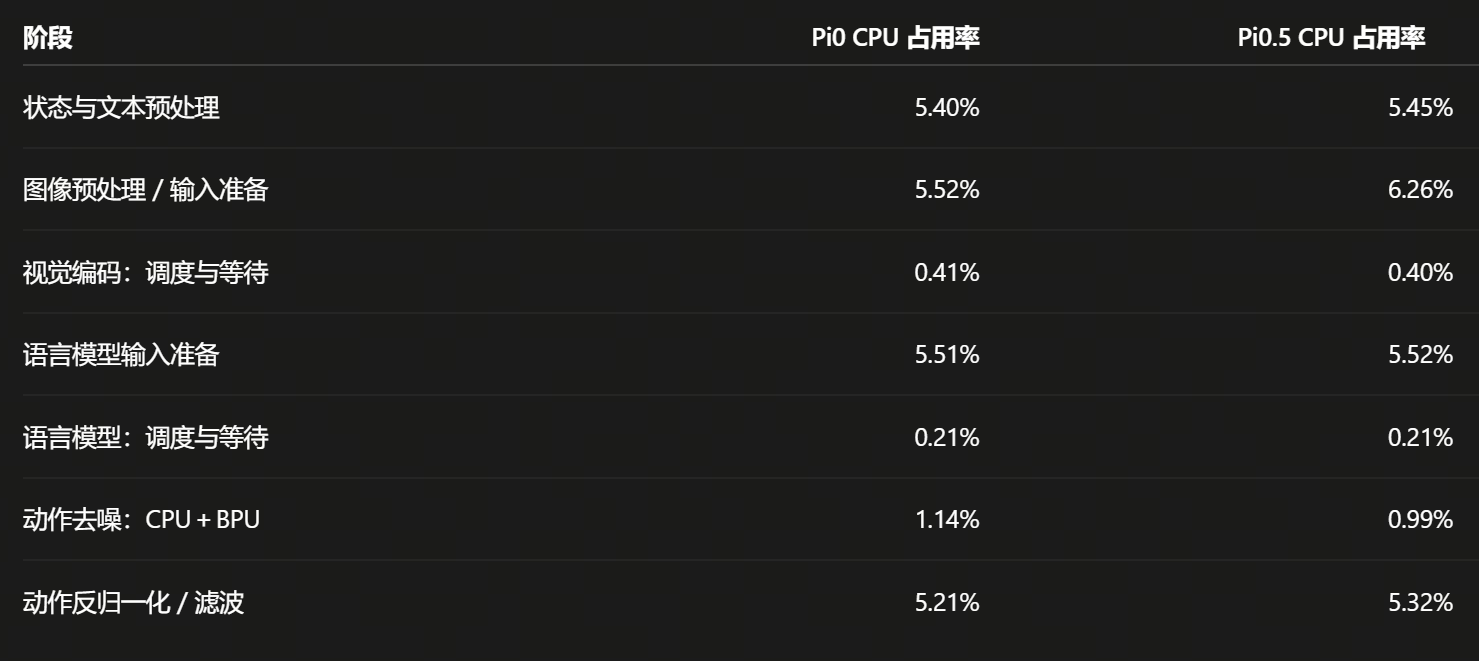
分阶段 CPU 占用